ثبت صوتی وقایع در دامداری؛ تبدیل گفتار کارگر به پرونده ساختاریافته دام با هوش مصنوعی
سامانه Voice-to-Form با تبدیل گفتار فارسی کارکنان دامداری به رکورد ساختاریافته، ثبت بیماری، تب، لنگش، زایش، درمان و وقایع روزانه دام را سریعتر و دقیقتر میکند.
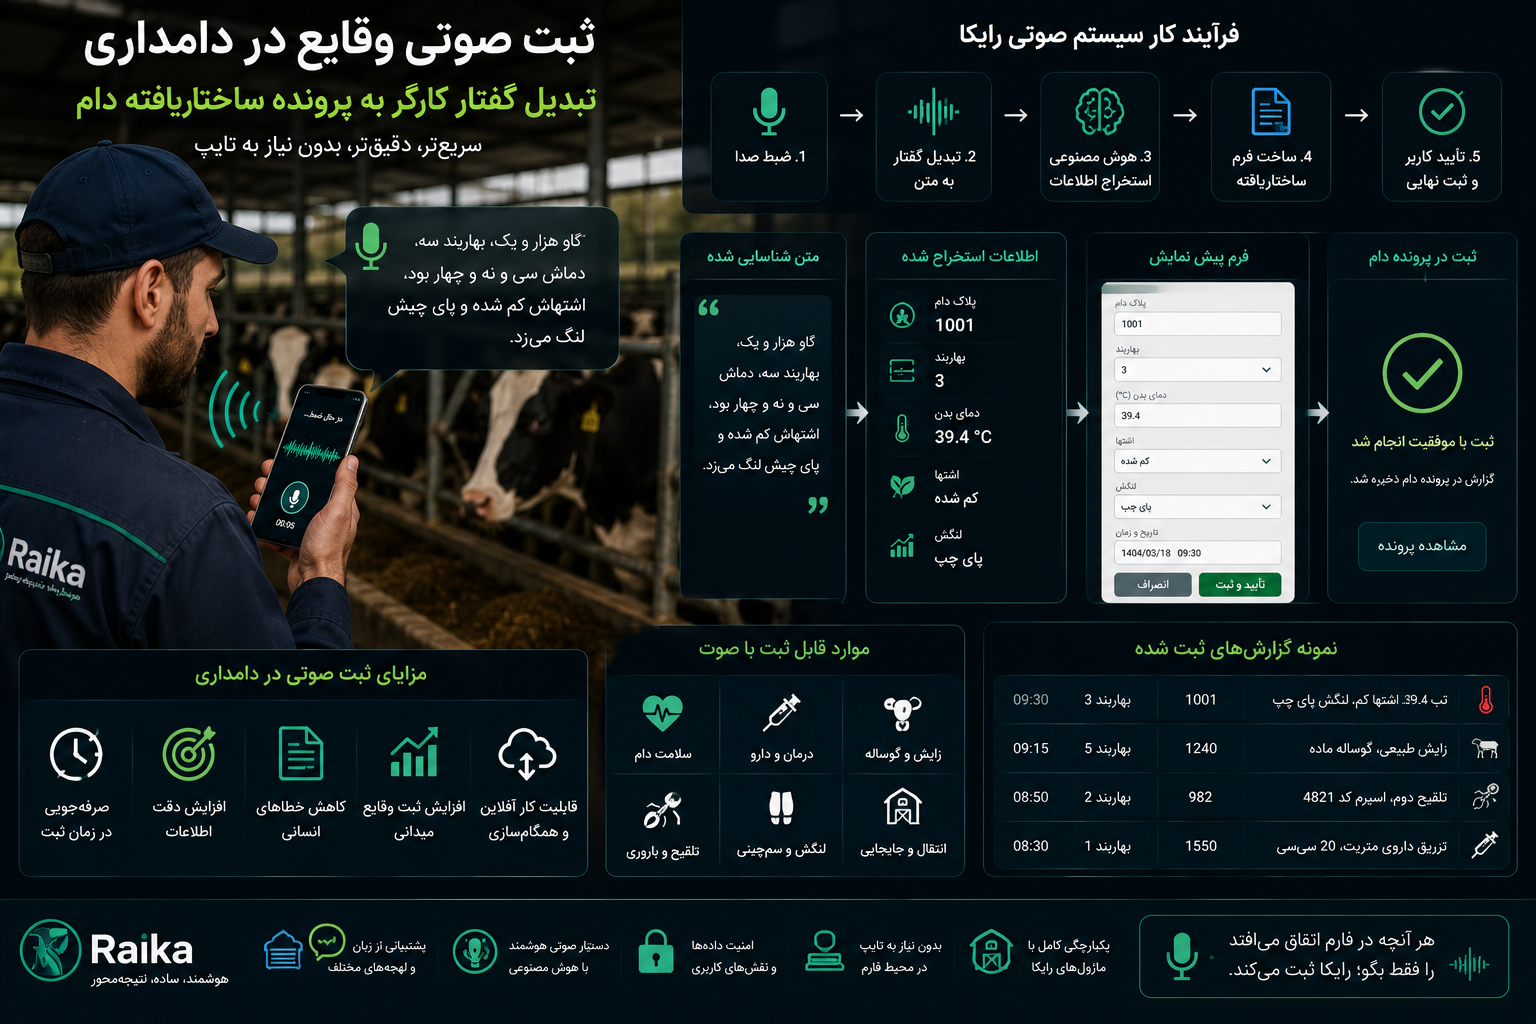
مقدمه؛ مشکل گاوداری کمبود داده نیست، ثبتنشدن اتفاقات است
در یک گاوداری صنعتی، هر روز دهها یا صدها اتفاق کوچک رخ میدهد.
یک گاو اشتهای کمتری دارد.
دام دیگری کمی لنگ میزند.
یک گاو تازه زایمان کرده است.
برای دام دیگری تب ثبت شده است.
یک کارتیه پستان غیرطبیعی به نظر میرسد.
یک دام به بهاربند دیگری منتقل شده است.
دارویی تزریق شده است.
گاو دیگری برای سمچینی علامتگذاری شده است.
ارزش مدیریتی این اتفاقها زمانی ایجاد میشود که در همان زمان، برای همان دام و بهصورت صحیح ثبت شوند.
اگر اتفاق در حافظه کارگر باقی بماند و چند ساعت بعد ثبت شود، احتمال فراموشی، جابهجایی شماره دام، اشتباه در عدد یا حذف بخشی از اطلاعات افزایش پیدا میکند.
ماژول ثبت صوتی وقایع یا Voice-to-Form Raika AI برای کاهش همین فاصله بین «مشاهده اتفاق» و «ثبت اطلاعات» طراحی شده است.
در معماری معرفیشده رایکا، کاربر در محیط فارم گزارش را به فارسی بیان میکند و سامانه تلاش میکند شماره پلاک، بهاربند، دمای بدن، علامت بالینی و سایر اطلاعات را استخراج کرده و قبل از ثبت، فرم ساختاریافته را برای تأیید کاربر نمایش دهد.
یک مثال بسیار ساده
کارگر هنگام گشت در بهاربند میگوید:
«گاو هزار و یک، بهاربند سه، دماش سی و نه و چهار بود، اشتهاش کم شده و پای چپش لنگ میزد.»
سامانه نباید فقط این جمله را به متن تبدیل کند.
هدف واقعی این است که آن را به چیزی شبیه این تبدیل کند:
Animal ID: IR-1001
Pen: 3
Temperature: 39.4°C
Appetite: Low
Lameness: Left limb
Status: Needs review
این تفاوت بسیار مهم است.
Speech-to-Text فقط صدا را به متن تبدیل میکند.
اما:
Voice-to-Form
باید گفتار را به داده ساختاریافته قابل استفاده در نرمافزار مدیریت فارم تبدیل کند.
معماری Voice-to-Form چگونه کار میکند؟
یک سیستم کامل میتواند چند مرحله داشته باشد:
صدای کاربر
↓
Automatic Speech Recognition
↓
متن فارسی
↓
Natural Language Processing
↓
استخراج موجودیتها
↓
اعتبارسنجی
↓
فرم پیشنمایش
↓
تأیید کاربر
↓
ثبت در پرونده دام
بنابراین یک ماژول Voice-to-Form صرفاً یک میکروفون نیست.
چند فناوری مختلف پشت آن قرار دارند.
مرحله اول: دریافت صدا
کاربر ممکن است گوشی را در محیطی استفاده کند که شرایط ایدهآل ضبط صدا ندارد.
در دامداری میتوان با مواردی مانند:
- صدای فن
- صدای گاو
- دستگاه شیردوشی
- تراکتور و میکسر
- صحبت سایر کارکنان
- فاصله متغیر گوشی از دهان
- باد
- محیط باز
- تفاوت لهجه
مواجه شد.
به همین دلیل کیفیت سیستم باید در شرایط واقعی فارم ارزیابی شود، نه فقط در اتاق ساکت.
تحقیقات مربوط به رابطهای صوتی کشاورزی نیز Noise Robustness را یکی از مسائل اصلی کاربرد عملی تشخیص گفتار معرفی میکنند.
مرحله دوم: Automatic Speech Recognition یا ASR
ASR مخفف:
Automatic Speech Recognition
است.
وظیفه این قسمت تبدیل:
Audio
↓
Text
است.
مثلاً:
صوت:
«گاو هزار و دویست و چهل تب سی و نه و چهار داشت»

↓ ASR

متن:
گاو ۱۲۴۰ تب ۳۹.۴ داشت
این مرحله هنوز درباره معنی جمله تصمیم نمیگیرد.
فقط تلاش میکند چیزی که گفته شده را صحیح بنویسد.
چرا فارسی برای ASR موضوع سادهای نیست؟
تشخیص گفتار فارسی طی سالهای اخیر پیشرفت زیادی کرده، اما تحقیقات جدید نشان میدهند عملکرد مدلها در فارسی استاندارد با شرایط واقعی و لهجههای مختلف یکسان نیست.
Benchmark جدید PSRB که برای ارزیابی سیستمهای تشخیص گفتار فارسی ساخته شده، نشان داده است که مدلهای ASR در فارسی استاندارد میتوانند عملکرد خوبی داشته باشند، اما در لهجههای منطقهای و برخی شرایط زبانی افت عملکرد مشاهده میشود. پژوهشگران بر ضرورت داده آموزشی متنوع و Fine-tuning مناسب تأکید کردهاند.
این موضوع برای دامداری ایران اهمیت ویژه دارد.
چون کارکنان فارم ممکن است با لهجههای:
- فارسی شیرازی
- ترکی
- کردی
- لری
- خراسانی
- مازندرانی
- یا فارسی غیررسمی
صحبت کنند.
بنابراین عبارت:
«پشتیبانی از فارسی»
بهتنهایی کافی نیست.
سیستم باید با فارسی واقعی کارکنان فارم آزمایش شود.
واژگان تخصصی دامداری یک چالش جداگانه هستند
مدل عمومی ممکن است کلماتی مثل:
کتوز
متریت
CMT
BCS
نشخوار
بهاربند
سمچینی
تلقیح
سیلانت
پروپیلن گلیکول
یا نام تجاری داروها را کمتر از واژههای روزمره دیده باشد.
همین موضوع باعث میشود یک ASR عمومی در محیط تخصصی خطا کند.
مثلاً:
گفته شده:
کتوز

تشخیص اشتباه:
کتوس
یا:
گفته شده:
بهاربند سه

تشخیص اشتباه:
بهار بند سه
از دید انسان تفاوت ممکن است کوچک باشد.
اما از دید Database تفاوت مهم است.
به همین دلیل Domain Adaptation و فرهنگ واژگان تخصصی اهمیت زیادی دارد.
مطالعات حوزه Speech Recognition در کشاورزی نیز نشان دادهاند که ساخت Corpus و Vocabulary متناسب با دامنه کشاورزی یکی از روشهای اصلی بهبود سیستمهای صوتی تخصصی بوده است.
تحقیقات فارسی نشان میدهند داده کافی اهمیت حیاتی دارد
پایگاه DeepMine یکی از مجموعههای بزرگ داده صوتی فارسی است و بیش از ۱,۸۵۰ گوینده و صدها ساعت گفتار را شامل میشود؛ این مجموعه برای تحقیقات تشخیص گفتار و تشخیص گوینده فارسی توسعه یافته است.
همچنین پژوهشهای جدیدتر مانند ParsVoice و benchmarkهای فارسی نشان میدهند اکوسیستم داده صوتی فارسی بهسرعت در حال توسعه است.
اما حتی داشتن مدل فارسی قدرتمند به معنی فهم صحیح اصطلاحات یک دامداری خاص نیست.
مرحله بعدی باید تطبیق مدل با دامنه تخصصی دامپروری باشد.
مرحله سوم: استخراج اطلاعات از جمله
فرض کنیم ASR جمله را صحیح تشخیص داده است:
«گاو ۱۲۴۰ در بهاربند سه دمای سی و نه و چهار داشت و اشتهاش کم بود.»
حالا NLP باید عناصر جمله را جدا کند.
مثلاً:
Animal ID → 1240

Pen → 3

Temperature → 39.4

Appetite → Low
این فرایند را میتوان:
Entity Extraction
یا:
Structured Information Extraction
نامید.
چرا ساختار اهمیت دارد؟
اگر فقط متن ذخیره شود:
«گاو ۱۲۴۰ دماش ۳۹.۴ بود و اشتهاش کم بود»
کامپیوتر بعداً برای تحلیل آن باید دوباره متن را بفهمد.
اما اگر داده بهصورت ساختاریافته باشد:
animal_id = 1240
temperature = 39.4
appetite = low
میتوان فوراً روی آن Query اجرا کرد.
مثلاً:
تمام گاوهای با temperature > 39.3
یا:
دامهای دارای appetite = low
در 24 ساعت گذشته
این همان دلیل اصلی اهمیت Voice-to-Form است.
مرحله چهارم: اعتبارسنجی داده
AI نباید هر چیزی را بدون کنترل وارد پرونده کند.
فرض کنید سیستم شنیده است:
Temperature = 49.4°C
ممکن است کاربر واقعاً گفته باشد:
39.4
یک Rule Engine میتواند تشخیص دهد که مقدار ثبتشده غیرعادی یا احتمالاً اشتباه است.
مثلاً:
IF temperature > plausible range
THEN
Request confirmation
یا اگر پلاک:
IR-98221
در فارم وجود ندارد:
Animal not found
نمایش داده شود.
این نوع Validation میتواند جلوی تبدیل خطای صوتی به خطای دیتابیس را بگیرد.
مرحله پنجم: پیشنمایش قبل از ثبت
این یکی از مهمترین بخشهای معماری پیشنهادی رایکاست.
جمله کاربر:
گاو ۱۰۰۱، بهاربند سه،
دما ۳۹.۴،
لنگش پای چپ،
اشتها پایین
سیستم فرم را نمایش میدهد:
پلاک: IR-1001 ✓
بهاربند: 3 ✓
دما: 39.4 ✓
لنگش: پای چپ ✓
اشتها: پایین ✓

[تأیید و ثبت]
تا زمانی که کاربر تأیید نکرده، داده نهایی وارد پرونده نمیشود.
صفحه فعلی رایکا نیز این مدل «Preview before save» را یکی از ویژگیهای Voice-to-Form معرفی میکند.
این تصمیم معماری بسیار مهم است، زیرا AI در تشخیص گفتار خطاپذیر است.
چرا Voice Input در محیط مزرعه ارزش دارد؟
در محیط اداری تایپ کردن آسان است.
در دامداری شرایط متفاوت است.
کاربر ممکن است:
- در حال راه رفتن باشد
- دستکش داشته باشد
- دستش آلوده باشد
- در حال نگهداشتن ابزار باشد
- مقابل دام ایستاده باشد
- بخواهد همزمان چند مشاهده را ثبت کند
در چنین محیطهایی Voice Interface میتواند اصطکاک تعامل با نرمافزار را کاهش دهد.
پژوهش Texas A&M University دقیقاً استفاده از Speech Interface برای Field Data Collection را بررسی کرده است و نتیجه گرفته که رابط صوتی برای کار میدانی پتانسیل قابلتوجهی دارد، هرچند محدودیتهای عملی مانند دقت و شرایط محیطی باید حل شوند.
تحقیق دانشگاه Texas A&M
در سال ۲۰۱۶ پایاننامهای در Texas A&M University با عنوان:
Developing a Speech-Based Interface for Field Data Collection
انجام شد.
پژوهشگر یک سیستم جمعآوری داده میدانی را با قابلیت:
- Speech Recognition
- Text-to-Speech
- Hands-Free Commands
توسعه داد.
هدف اصلی کاهش نیاز به تعامل دستی هنگام کار میدانی بود.
نتیجه نشان داد مفهوم رابط صوتی برای Field Data Collection عملی و امیدوارکننده است، اما برای استفاده گسترده باید محدودیتهای محیط واقعی برطرف شوند.
هند؛ یکی از مهمترین کشورها در تحقیقات Voice Agriculture
استفاده از Voice Interface در کشاورزی هند سابقه قابل توجهی دارد.
یکی از دلایل آن وجود:
- زبانهای متعدد
- کاربران با سطح سواد متفاوت
- نیاز به استفاده ساده از سیستمهای دیجیتال
است.
پژوهشهای مختلف روی سیستمهای گفتاری برای:
- قیمت محصولات
- اطلاعات کشاورزی
- علائم بیماری گیاه
- پرسش و پاسخ کشاورزی
انجام شدهاند.
Avaaj Otalo؛ نمونه مهم استفاده واقعی
یکی از پروژههای شناختهشده در این حوزه Avaaj Otalo در هند بود.
این سیستم یک Voice Application برای کشاورزان کوچک بود و به کاربران اجازه میداد با استفاده از تلفن و صدا به اطلاعات کشاورزی دسترسی داشته باشند.
مطالعه میدانی آن در جامعه واقعی کشاورزان انجام شد و یکی از نمونههای پرارجاع Human-Computer Interaction در کشاورزی محسوب میشود.
Speech Recognition تخصصی برای کشاورزی هند
مطالعات دیگری نیز روی دیتابیسهای صوتی مخصوص کشاورزی در زبانهای محلی هند انجام شدهاند.
یک مرور تخصصی در حوزه Speech Recognition Agriculture مواردی مانند:
- Marathi
- Kannada
- Mandarin agricultural systems
- Commodity information systems
را بررسی کرده است.
نکته اصلی این مطالعات این است:
Vocabulary تخصصی و داده صوتی همان حوزه برای عملکرد قابل اعتماد اهمیت دارد.
این موضوع مستقیماً با ایده Raika AI برای Vocabulary تخصصی دامداری فارسی مرتبط است.
غنا؛ Voice Interface برای کشاورزان
در شمال غنا نیز پژوهشهای HCI درباره سیستمهای Voice-Based برای بازاریابی محصولات کشاورزی انجام شدهاند.
هدف این پروژهها کاهش موانع استفاده از فناوری برای کشاورزان و امکان تعامل از طریق Voice بود.
این نمونهها نشان میدهند Voice Interface در کشاورزی فقط یک ایده آزمایشگاهی نیست و در کشورهای مختلف بهعنوان ابزار دسترسی سادهتر به فناوری بررسی شده است.
کنیا و نسل جدید Voice + AI
نسل جدید سامانهها در حال ترکیب:
Voice + LLM + Agricultural Knowledge
است.
مطالعات جدید درباره دستیارهای هوشمند کشاورزی در کنیا نشان میدهند کاربران میتوانند از رابط صوتی برای دریافت توصیههای کشاورزی استفاده کنند و آزمایشهای میدانی نیز Utility و Usability این روش را بررسی کردهاند.
این جهتگیری نشان میدهد Voice Interface بهتدریج از IVRهای ساده به سمت Conversational AI حرکت کرده است.
تفاوت Voice Assistant با Voice-to-Form
این دو فناوری یکسان نیستند.
Voice Assistant:
کاربر سؤال میکند
↓
سیستم پاسخ میدهد
Voice-to-Form:
کاربر یک رخداد میگوید
↓
سیستم اطلاعات را استخراج میکند
↓
فرم Database ساخته میشود
برای گاوداری، Voice-to-Form در بسیاری از عملیات روزانه حتی مهمتر است.
زیرا مسئله فقط «پرسیدن» نیست.
مسئله ثبت داده با کیفیت است.
سناریوی سلامت دام
کارگر میگوید:
«گاو ۸۵۰ امروز اشتها نداشت، نشخوارش کم بود و دماش ۳۹.۵ بود.»
سیستم:
Animal: IR-850
Appetite: Low
Rumination: Low
Temperature: 39.5°C
سپس:
Alert:
Clinical review required
و دام وارد:
Vet Checklist
میشود.
سناریوی زایش
کاربر میگوید:
«گاو ۱۲۴۰ زایش طبیعی داشت، گوساله ماده بود.»
سیستم:
Animal ID: 1240
Event: Calving
Calving Type: Normal
Calf Sex: Female
سپس ممکن است:
- DIM ریست شود
- وضعیت دام به Fresh Cow تغییر کند
- برنامه معاینه پس از زایش فعال شود
- رکورد گوساله ایجاد شود
همه این عملیات میتوانند از یک گزارش صوتی آغاز شوند.
سناریوی تلقیح
تلقیحکار میگوید:
«پلاک ۹۸۲، تلقیح دوم، اسپرم کد ۴۸۲۱.»
سیستم استخراج میکند:
Animal ID: 982
Event: AI
Attempt: 2
Semen Code: 4821
سپس کاربر تأیید میکند.
سناریوی دارودرمانی
دامپزشک میگوید:
«گاو ۱۵۵۰، متریت، داروی فلان، ۲۰ سیسی، سه روز.»
Voice-to-Form میتواند فرم درمان را آماده کند.
اما اینجا یک اصل حیاتی وجود دارد:
سیستم نباید خودش دوز یا دارو را حدس بزند.
فقط باید چیزی را که متخصص گفته است استخراج کند.
Voice Input برای تغییر مکان دام
کارگر میتواند بگوید:
«گاو ۷۸۲ از بهاربند دو رفت به بهاربند چهار.»
فرم:
Animal: 782
From Pen: 2
To Pen: 4
Event: Transfer
اینجا Voice به ابزار لجستیک فارم هم تبدیل میشود.
چرا Timestamp خودکار مهم است؟
هر گزارش Voice میتواند بهصورت خودکار:
Date
Time
User
Device
Location/Pen
داشته باشد.
در نتیجه سیستم میداند:
چه کسی، چه زمانی، چه چیزی را ثبت کرده است.
این قابلیت برای Audit Trail بسیار مهم است.
حتی خود فایل صوتی میتواند نگهداری شود
در سیستم پیشرفته میتوان:
Original Audio
+
Transcription
+
Structured Data
را نگهداری کرد.
این ساختار مزیت مهمی دارد.
اگر بعداً اختلاف یا اشتباهی وجود داشته باشد، میتوان گزارش اصلی را بررسی کرد.
البته نگهداری Audio باید با سیاست دسترسی، حجم Storage و حریم خصوصی کارکنان هماهنگ شود.
Confidence Score
ASR نباید همه نتایج را با اعتماد یکسان نمایش دهد.
مثلاً:
Animal ID: 1240
Confidence: 99%

Temperature: 39.4
Confidence: 96%

Drug name:
Confidence: 61%
اگر Confidence پایین باشد:
⚠ لطفاً نام دارو را تأیید کنید.
این مدل بسیار امنتر از ثبت خودکار است.
Confirmation باید هوشمند باشد
نیازی نیست کاربر همیشه کل فرم را دوباره بررسی کند.
مثلاً:
پلاک ✓
بهاربند ✓
دما ✓

دارو ?
سیستم میتواند فقط بخش نامطمئن را برجسته کند.
این باعث میشود سرعت بالا بماند ولی امنیت کاهش پیدا نکند.
اعداد یکی از حساسترین نقاط تشخیص گفتار هستند
در گاوداری، عدد اهمیت بسیار زیادی دارد:
- پلاک
- دما
- دوز
- وزن
- مقدار شیر
- شماره بهاربند
- کد اسپرم
یک اشتباه کوچک میتواند معنای رکورد را کاملاً تغییر دهد.
مثلاً:
13.5 ml
با:
30.5 ml
یکسان نیست.
بنابراین معماری مناسب باید برای اعداد Ruleهای سختگیرانهتری داشته باشد.
نام داروها نیز High-Risk Field هستند
برای دارو بهتر است:
Speech
↓
Candidate list
↓
Database drug match
↓
Human confirmation
انجام شود.
مثلاً اگر کاربر نام یک دارو را بگوید، سیستم بهجای ایجاد نام آزاد، باید آن را با Pharmacy Master Data مقایسه کند.
Voice-to-Form و Master Data
بهترین معماری:
Speech
↓
Entity
↓
Master Database Validation
مثلاً:
Animal → cattle table
Pen → pen table
Drug → pharmacy table
Disease → diagnosis codes
Semen → semen inventory
این کار خطا را بهشدت محدود میکند.
آیا سیستم باید همیشه آنلاین باشد؟
خیر.
در فارم احتمال ضعف اینترنت وجود دارد.
در طراحی فعلی صفحه رایکا، حالت Offline و همگامسازی بعدی نیز برای این ماژول ذکر شده است.
معماری Offline میتواند باشد:
Voice Event
↓
Local processing / local queue
↓
Stored on device
↓
Internet restored
↓
Cloud Sync
اما باید مشخص شود کدام بخشها واقعاً روی Device اجرا میشوند و کدام نیاز به Cloud دارند.
Offline واقعی با «ذخیره برای ارسال بعدی» فرق دارد
دو معماری ممکن است:
حالت اول
Record audio offline
↓
Send when online
↓
AI processing
این فقط Offline Capture است.
حالت دوم
Record
↓
ASR on device
↓
Entity extraction
↓
Form creation
این Offline AI واقعی است.
این دو نباید در معرفی محصول با هم اشتباه شوند.
چرا Voice-to-Form میتواند کیفیت Data را بهتر کند؟
فرض کنید کارگر اتفاق را میبیند.
در روش سنتی:
مشاهده
↓
به خاطر سپردن
↓
پایان گشت
↓
بازگشت به دفتر
↓
ورود اطلاعات
در هر مرحله امکان Data Loss وجود دارد.
Voice-to-Form:
مشاهده
↓
گفتن
↓
ثبت
فاصله زمانی را بسیار کمتر میکند.
اما Voice الزاماً خطا را صفر نمیکند
این نکته بسیار مهم است.
Voice ممکن است بعضی خطاهای تایپی را حذف کند، اما نوع دیگری از خطا را وارد کند:
Speech Recognition Error
به همین دلیل ادعای:
«حذف خطاهای انسانی تایپ»
نباید به معنی:
«صفر شدن خطای ثبت»
تفسیر شود.
سیستم فقط نوع و محل خطا را تغییر میدهد.
Noise بزرگترین دشمن سیستم میدانی است
فرض کنید Fan در پسزمینه کار میکند.
یا Cow Vocalization همزمان ضبط میشود.
مدل ASR ممکن است کلمات را اشتباه تشخیص دهد.
تحقیقات مربوط به رابطهای صوتی کشاورزی نیز بر تفاوت شرایط آزمایشگاهی و محیط واقعی تأکید میکنند.
بنابراین تست واقعی رایکا باید داخل دامداری انجام شود.
Benchmark صحیح رایکا چه باید باشد؟
برای ارزیابی سیستم بهتر است حداقل این شاخصها اندازهگیری شوند:
Word Error Rate
WER
دقت تبدیل صوت به متن.
Entity Accuracy
آیا:
پلاک
دما
بهاربند
دارو
علامت
صحیح استخراج شدند؟
Form Accuracy
چند فرم بدون اصلاح ذخیره شدند؟
Correction Rate
کاربر چند بار مجبور به اصلاح شد؟
Time per Event
ثبت یک رخداد چند ثانیه طول کشید؟
Event Capture Rate
قبل و بعد از Voice چند درصد رخدادها واقعاً ثبت شدند؟
مهمترین KPI شاید WER نباشد
ممکن است Transcript دقیقاً صحیح نباشد اما فیلدهای مهم درست استخراج شوند.
مثلاً:
گفته شده:
«گاو هزار و یک تو بهاربند سه یه کم لنگ میزد.»
ASR:
«گاو ۱۰۰۱ توی بهار بند ۳ کمی لنگ میزد.»
از نظر Word Error ممکن است تفاوتهایی باشد.
اما:
Animal = 1001
Pen = 3
Lameness = Yes
کاملاً صحیح است.
برای Voice-to-Form، Entity Accuracy گاهی از متن کلمهبهکلمه مهمتر است.
مدل فارسی باید با کارکنان واقعی تست شود
Benchmarkهای جدید فارسی نشان دادهاند لهجههای منطقهای یکی از نقاط ضعف سیستمهای عمومی ASR هستند.
بنابراین تست رایکا بهتر است شامل:
- استانهای مختلف
- گروههای سنی مختلف
- سرعت گفتار متفاوت
- محیطهای شلوغ
- کاربران کمتجربه
- کاربران حرفهای فارم
باشد.
این دقیقاً چیزی است که میتواند ادعای «پشتیبانی از لهجهها» را از ادعای بازاریابی به نتیجه قابل اندازهگیری تبدیل کند.
واژهنامه اختصاصی هر فارم
حتی دو گاوداری ممکن است اصطلاحات متفاوت داشته باشند.
مثلاً یک فارم میگوید:
Fresh Pen
فارم دیگر:
تازهزا
و فارم سوم:
بهاربند 7
سیستم میتواند Alias داشته باشد.
مثلاً:
تازهزا
Fresh
Fresh Cow
سالن تازهزا
همگی به:
PEN_ID = 7
نگاشت شوند.
Personalization برای کاربران
سیستم میتواند در طول زمان بفهمد کاربر خاص چگونه صحبت میکند.
مثلاً یک کاربر همیشه:
سی و نه چهار
میگوید.
کاربر دیگری:
سی و نه ممیز چهار
هر دو باید:
39.4
تفسیر شوند.
Voice-to-Form فقط برای سلامت نیست
کاربردهای ممکن:
- بیماری
- درمان
- زایش
- تلقیح
- سونوگرافی
- انتقال بهاربند
- سمچینی
- BCS
- وزن
- تلفات
- خوراک
- خرابی تجهیزات
- موجودی انبار
- شیردوشی
بنابراین Voice Interface میتواند به یک لایه ورود اطلاعات برای کل سیستم فارم تبدیل شود.
رابطه Voice-to-Form با Digital Twin
مقاله Digital Twin توضیح داد که مدل هر دام برای بهروز ماندن نیاز به Data دارد.
Voice-to-Form یکی از ورودیهای این داده است.
Worker observation
↓
Voice-to-Form
↓
Database
↓
Digital Twin
بدون Data تازه، Digital Twin نیز ناقص است.
رابطه با پایش روزانه
کارگر میگوید:
گاو ۱۰۰۱ امروز اشتها نداشت
Voice-to-Form آن را ثبت میکند.
Daily Monitoring فردا میبیند:
Appetite ↓
Milk ↓
Rumination ↓
و هشدار تولید میکند.
در نتیجه گزارش انسانی و Sensor Data به هم متصل میشوند.
رابطه با CBR
اگر گزارش صوتی تبدیل شود به:
Temperature = 39.6
Milk Drop = 18%
Appetite = Low
Lameness = No
CBR میتواند از همین داده برای پیدا کردن موارد مشابه استفاده کند.
بنابراین:
Voice
↓
Structured Case
↓
CBR
رابطه با AI Farm Copilot
Voice-to-Form:
داده وارد سیستم میکند.
AI Farm Copilot:
داده را از سیستم میپرسد.
مثلاً صبح:
«گاو ۱۰۰۱ تب داشت و اشتهاش کم بود.»
ثبت میشود.
عصر مدیر میپرسد:
«امروز چه گاوهایی تب داشتند؟»
Copilot همان Data را بازیابی میکند.
مزیت سازمانی: کاهش وابستگی به دفتر
در نرمافزارهای سنتی، ثبت Data ممکن است به یک نفر در دفتر وابسته باشد.
کارگر گزارش میدهد.
فرد دوم آن را وارد نرمافزار میکند.
Voice-to-Form میتواند واسطه را کاهش دهد.
اما کنترل سطح دسترسی باید حفظ شود.
مثلاً:
Worker
→ Observation only

Veterinarian
→ Diagnosis + Treatment

Manager
→ Approval / Review
امنیت نقشها مهم است
اینکه کاربر بتواند Voice Input داشته باشد به معنی اجازه تغییر همه اطلاعات نیست.
مثلاً کارگر میتواند بگوید:
دام لنگش دارد
اما نباید بتواند با Voice:
Diagnosis = ...
Drug = ...
را نهایی کند مگر Role مناسب داشته باشد.
Voice باید همان Permission Model نرمافزار را رعایت کند.
Human-in-the-Loop اصل اصلی است
بهترین معماری:
AI proposes
Human confirms
System records
نه:
AI hears
AI assumes
AI saves
این اصل خصوصاً برای:
- دارو
- دوز
- تشخیص
- تلفات
- حذف دام
- تولیدمثل
اهمیت زیادی دارد.
آیا Voice واقعاً ثبت رخدادها را سه برابر میکند؟
در صفحه فعلی رایکا برای ماژول Voice-to-Form عبارت:
«ثبت ۳ برابری رخدادهای میدانی و حذف خطاهای انسانی تایپ»
ذکر شده است.
از نظر مفهومی کاهش اصطکاک ثبت میتواند Capture Rate را افزایش دهد.
تحقیقات Field Data Collection نیز ظرفیت Voice Interface برای کاهش تعامل دستی را تأیید میکنند.
اما عدد دقیق ۳ برابر باید با مطالعه واقعی خود رایکا اثبات شود.
مطالعه مناسب برای اثبات ادعای رایکا
مثلاً:
ماه اول
روش عادی:
Recorded events = 1,000
ماه دوم
Voice-to-Form:
Recorded events = 2,600
سپس باید بررسی شود:
- تعداد دام ثابت بوده؟
- تعداد کارکنان ثابت بوده؟
- فصل مشابه بوده؟
- تعریف Event ثابت بوده؟
- تغییر مدیریت دیگری رخ نداده؟
بعد میتوان عدد معتبر منتشر کرد.
درباره «حذف خطای تایپ»
عبارت علمیتر میتواند این باشد:
«کاهش نیاز به تایپ دستی و کاهش بخشی از خطاهای ورود اطلاعات، همراه با تأیید انسانی قبل از ثبت.»
چون خطای ASR همچنان ممکن است وجود داشته باشد.
این بیان هم دقیقتر است و هم اعتماد بیشتری ایجاد میکند.
کشورهای دارای تحقیقات و کاربردهای Voice Agriculture
ایالات متحده آمریکا
Texas A&M University رابط صوتی برای جمعآوری داده Field را بررسی کرده است.
هند
پروژهها و تحقیقات متعددی درباره:
- Voice Information Retrieval
- Agricultural IVR
- Local-language speech recognition
- Farmer voice interfaces
انجام شده است.
غنا
Voice-Based systems برای ارتباط و بازاریابی کشاورزان در مطالعات میدانی مورد بررسی قرار گرفتهاند.
کنیا
نسل جدید سیستمهای Voice + AI برای ارائه خدمات کشاورزی به کشاورزان در حال ارزیابی است.
این موارد به معنی استفاده از سامانه رایکا در این کشورها نیست.
آنها نمونههای علمی و عملی استفاده از Voice Interface در کشاورزی هستند.
تفاوت رایکا با بسیاری از این نمونهها
بخش زیادی از پروژههای قبلی Voice Agriculture برای:
Question
↓
Answer
طراحی شدهاند.
هدف Voice-to-Form رایکا متفاوت است:
Observation
↓
Structured Farm Record
یعنی Voice مستقیماً به عملیات مدیریت دام متصل میشود.
این میتواند ارزش بسیار بالایی داشته باشد، به شرط آنکه دقت و Validation جدی گرفته شود.
آینده؛ Multimodal Field Entry
در آینده کارگر ممکن است بگوید:
«این گاو پای چپش لنگ میزنه.»
همزمان دوربین گوشی دام را ببیند.
سامانه:
Voice
+
Image
+
Animal ID
+
Sensor data
را ترکیب کند.
سپس فرم ایجاد شود.
این مدل:
Multimodal AI
است.
مثال آیندهای کامل
کارگر پلاک را با دوربین اسکن میکند:
IR-1240
سپس میگوید:
«کارتیه عقب راست متورمه و CMT مثبت دو بود.»
سیستم:
Animal = IR-1240
Udder Quarter = Rear Right
CMT = 2
Observation = Swelling
و عکس نیز ضمیمه میشود.
این بسیار قدرتمندتر از Voice بهتنهایی است.
Voice بهعنوان بخشی از Digital Transformation فارم
دیجیتالیکردن فارم فقط نصب Sensor نیست.
اگر اطلاعات انسانی ثبت نشوند، تصویر سیستم ناقص خواهد بود.
بعضی دادهها فقط توسط انسان دیده میشوند:
- نوع ترشح
- رفتار غیرعادی
- لنگش ظریف
- خرابی تجهیزات
- شرایط خوراک
- مشکل آبخوری
- اتفاقات غیرمنتظره
Voice یکی از سریعترین روشهای تبدیل این Observations به Data است.
نتیجهگیری
یکی از بزرگترین مشکلات مدیریت گاوداری فاصله بین:
آنچه در میدان اتفاق افتاده
و:
آنچه در دیتابیس ثبت شده
است.
هرچه این فاصله بزرگتر شود، کیفیت تصمیمگیری پایینتر میآید.
Voice-to-Form تلاش میکند این فاصله را کوتاه کند.
کاربر مشاهده میکند.
صحبت میکند.
AI صدا را به متن تبدیل میکند.
اطلاعات کلیدی را استخراج میکند.
فرم را میسازد.
سیستم آن را اعتبارسنجی میکند.
کاربر تأیید میکند.
و رکورد فوراً به پرونده دام اضافه میشود.
ارزش واقعی این فناوری در «صحبت کردن با کامپیوتر» نیست.
ارزش آن در این است که:
اطلاعاتی که قبلاً ممکن بود فراموش شوند، ناقص ثبت شوند یا اصلاً ثبت نشوند، به داده ساختاریافته قابل تحلیل تبدیل شوند.
وقتی همین داده به:
- پایش هوشمند
- Digital Twin
- CBR
- Hidden Waste Tracker
- AI Farm Copilot
- BI Dashboard
متصل شود، یک گزارش صوتی چندثانیهای میتواند در ادامه بخشی از کل زنجیره تصمیمگیری فارم شود.
این همان جایی است که Voice Interface از یک قابلیت جذاب نرمافزاری به یک ابزار عملیاتی واقعی برای دامداری دقیق تبدیل میشود.
منابع علمی و دانشگاهی
- سامانه هوشمند گاوداری رایکا — Voice-to-Form Raika AI — https://raikaanimal.com/smart-farm/
- Texas A&M University — Developing a Speech-Based Interface for Field Data Collection — Kaitlyn Cheri Becker, 2016 https://oaktrust.library.tamu.edu/server/api/core/bitstreams/786e14f3-1c5c-4b81-a396-9525d4b0b300/content
- Hase & Nimbhore — Speech Recognition Techniques in Agriculture Sector: A Comparative Study — https://eudl.eu/pdf/10.4108/eai.24-3-2022.2318772
- Patel et al. — Avaaj Otalo: A Field Study of an Interactive Voice Application for Small Farmers — ACM CHI https://dl.acm.org/doi/10.1145/1753326.1753434
- Voice-Based Marketing for Agricultural Products — Rural Northern Ghana — ACM https://dl.acm.org/doi/10.1145/2517899.2517924
- Chandra et al. — Digital Agriculture for Small-Scale Producers — Communications of the ACM, 2021 https://dl.acm.org/doi/10.1145/3454008
- PSRB — A Comprehensive Benchmark for Evaluating Persian ASR Systems — 2025 https://arxiv.org/abs/2505.21230
- DeepMine — A Large-Scale Persian and English Speech Corpus — https://arxiv.org/abs/1912.03627
- Arman-AV — Large-Scale Persian Audio-Visual Speech Dataset — https://arxiv.org/abs/2301.10180
- ManaTTS Persian — Persian Speech Dataset and Processing Framework — NAACL 2025 https://aclanthology.org/2025.naacl-long.464/
- ParsVoice — Large-Scale Multi-Speaker Persian Speech Dataset — https://arxiv.org/html/2510.10774
- Foundation Models in Agriculture — Comprehensive Review — Agriculture, 2025 https://www.mdpi.com/2077-0472/15/8/847
مقالات دیگر
 همگامسازی بلادرنگ ابری در گاوداری؛ اتصال اپ میدانی، سنسورها و کنسول مدیریت در یک سیستم واحد
 اپلیکیشن میدانی PWA در گاوداری؛ ثبت آفلاین اطلاعات دام در محیط واقعی فارم
 پایش روزانه و هشدارهای هوشمند گله؛ قلب تصمیمگیری دادهمحور در گاوداری مدرن
 ردیاب اتلاف پنهان در گاوداری؛ تبدیل زیانهای نامرئی به فرصت افزایش سود
 دوقلوی دیجیتال دام؛ ساخت نسخه محاسباتی اختصاصی از هر گاو برای پیشبینی سلامت و تولید
 حافظه تجارب مشابه در گاوداری؛ چگونه هوش مصنوعی از پروندههای درمانی گذشته برای تصمیم بهتر دامپزشک استفاده میکند
 تحلیل جامع ۳۶۰ درجه پرونده دام؛ تبدیل صدها داده پراکنده به یک تصمیم عملی برای هر گاو
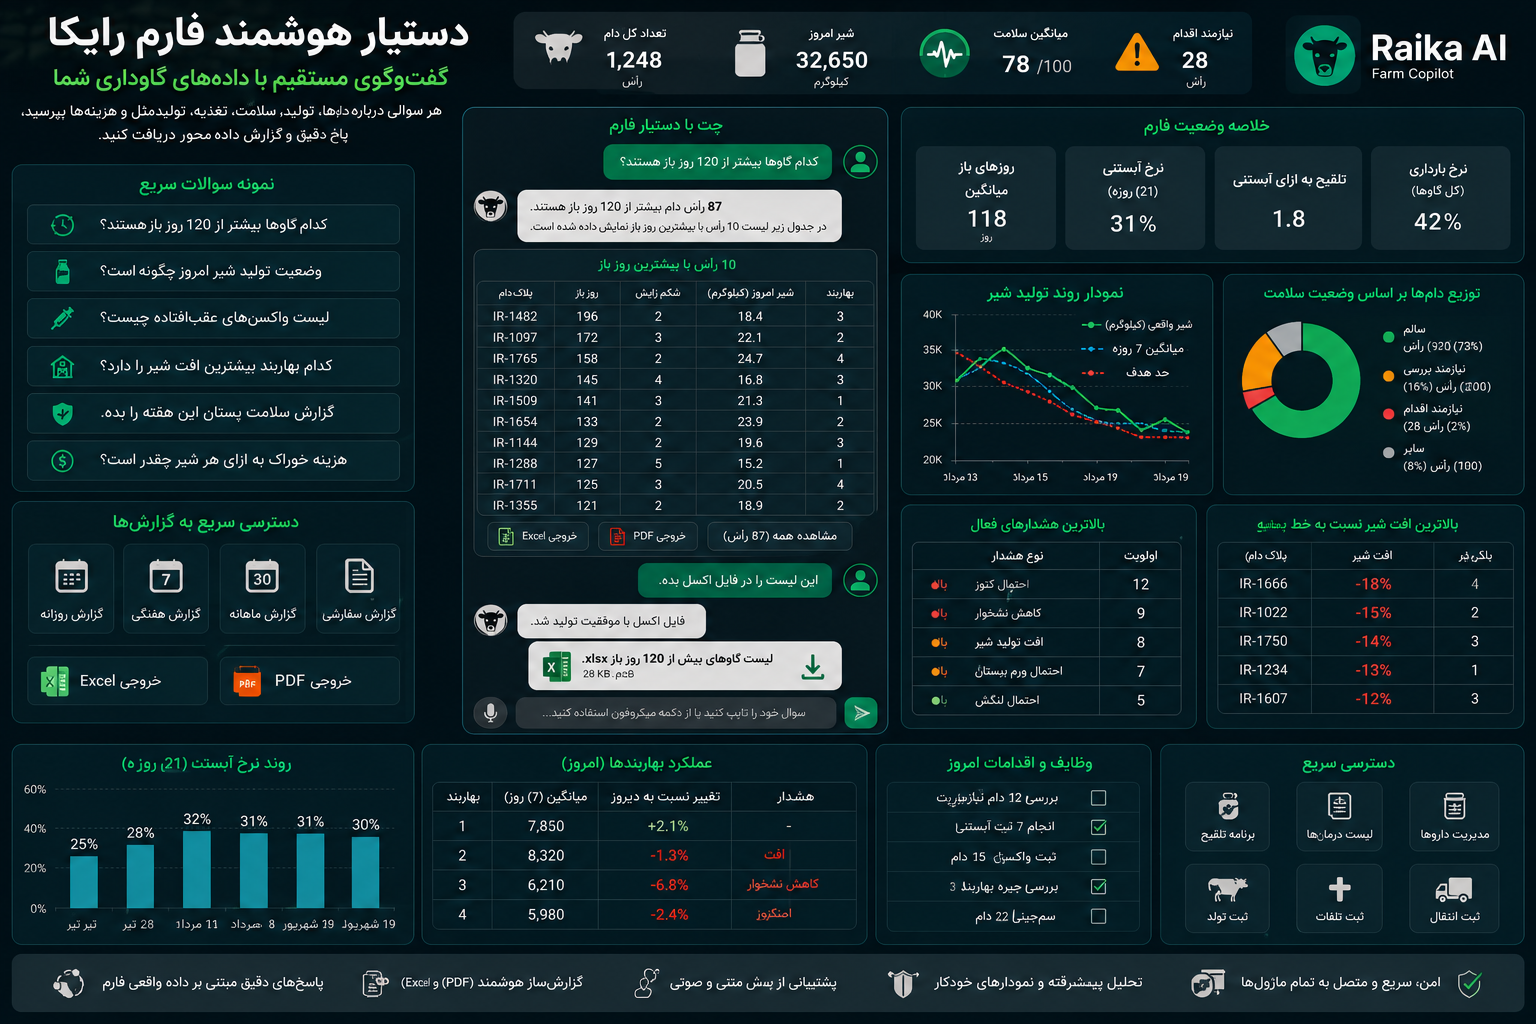 دستیار هوشمند فارم؛ گفتوگوی مستقیم با دادههای گاوداری و ساخت گزارش با زبان طبیعی
 داشبورد مدیریتی و هوش تجاری در گاوداری؛ تبدیل هزاران رکورد روزانه به چند شاخص حیاتی برای تصمیم مدیر
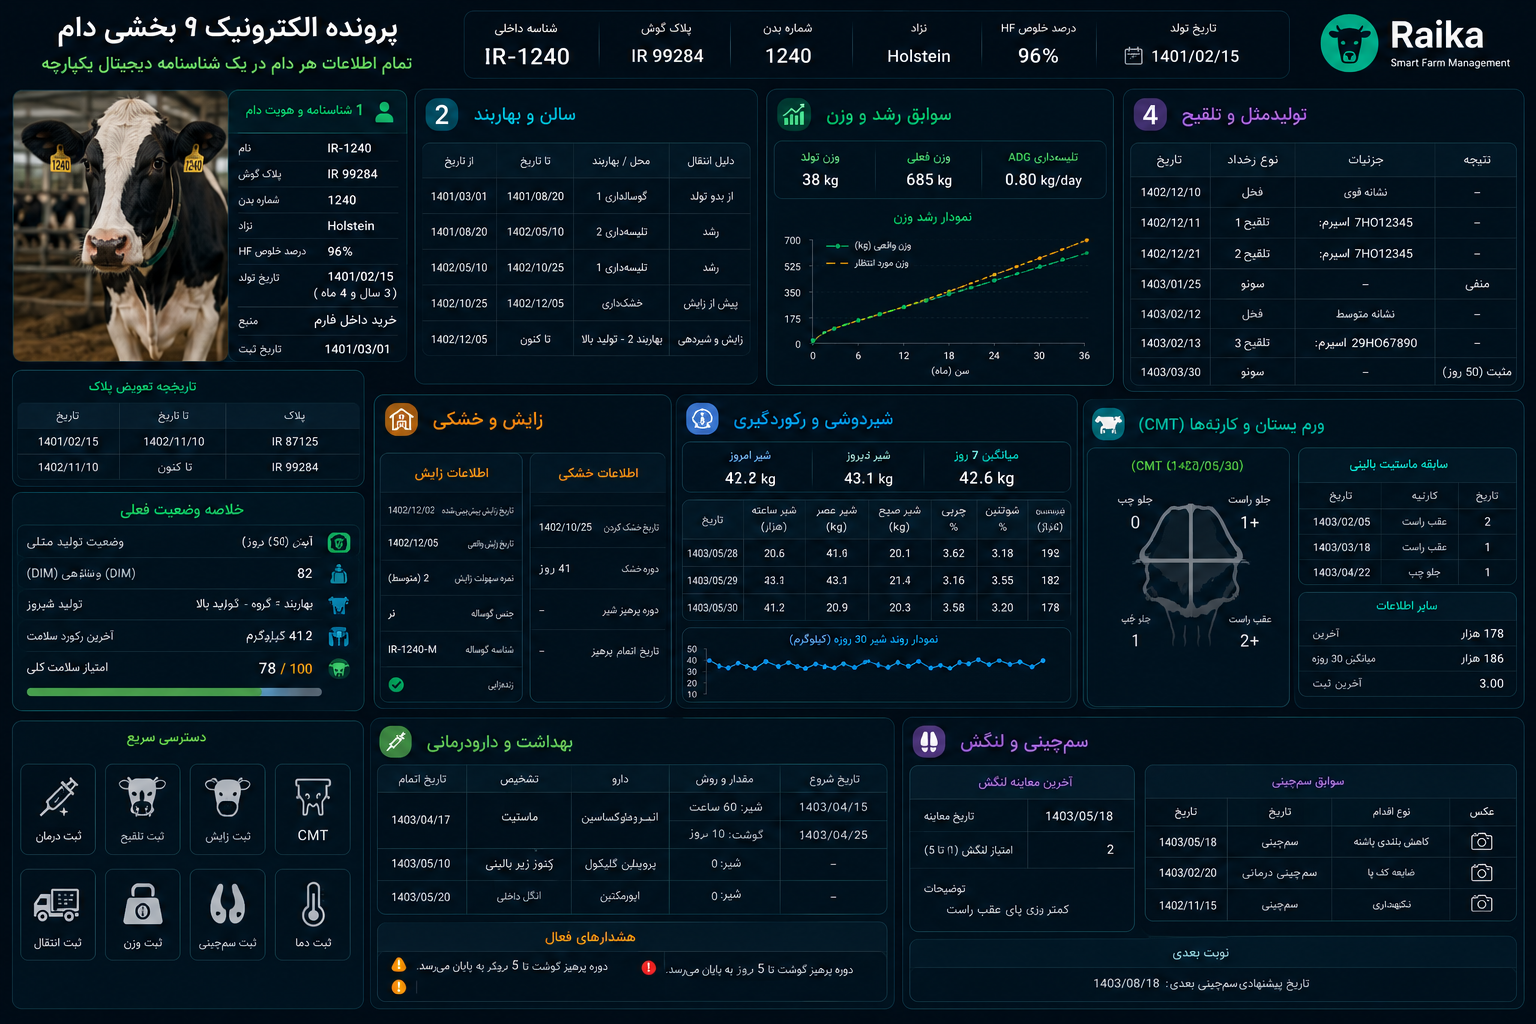 پرونده الکترونیک ۹ بخشی دام؛ از شناسنامه و شیر تا درمان، باروری و لنگش در یک پرونده یکپارچه